人工智能时代,散落在一个个“孤岛”中的数据,如何连接成网,更好地服务科研?针对这个问题,同济大学校长杨金龙院士在2026浦江创新论坛上带来主旨报告。
以下为演讲实录
杨金龙:我今天报告的题目是《从数据孤岛到知识网络——构建面向科学智能的数据生态》,主要分享近几年来围绕数据+AI的一些实践和思考。
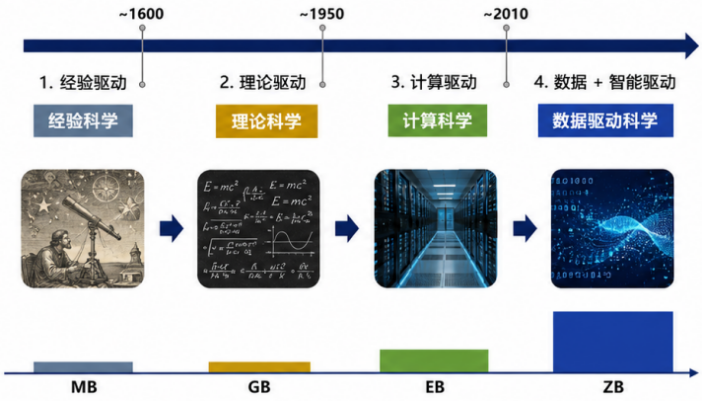
过去几百年,科学研究先后经历了经验驱动、理论驱动、计算驱动,现在正进入数据与智能驱动新阶段,数据已经不再只是实验和计算的副产品,而是成为可以与理论、实验、计算并列的重要科研要素,并上升为国家战略资源。科学数据的“汇交-治理-生态-使用”闭环,正成为释放AI科研生产力的关键底座。
前AI与科学融合面临的一个核心挑战是:高质量数据集正在耗尽。强化学习之父、2025年图灵奖得主Richard S. Sutton指出“依靠已有数据无法产生新知识”,因此各国都在布局生成式科研引擎或AI for Science,本质上都在回答一个问题“未来的高质量科学数据从哪里来?”
从“数据大国”走向“数据强国”
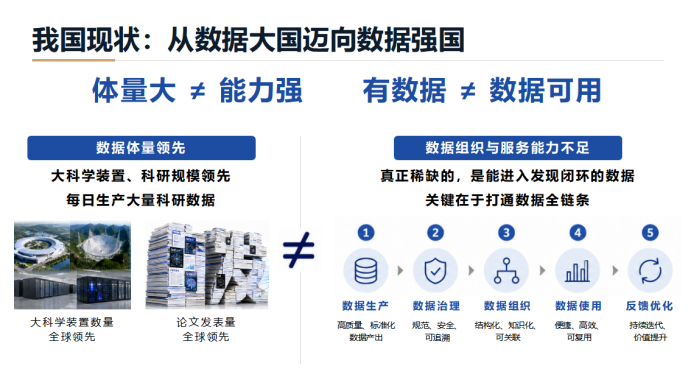
再看我国的现状,我们并不缺数据。我国大科学装置的数据量、科研规模和论文产出都处于全球前列,每天产生海量科研数据,但是体量大不等于能力强,有数据不等于数据可用。真正稀缺的是能够进入科学发现闭环,被机器直接使用的数据。其中的关键,是打通数据生产、治理、组织、使用和反馈的全链条,推动我国从数据大国真正走向数据强国。
围绕这样一个目标,我今天主要想回答三个问题。
第一,为什么大量科学数据会变成彼此孤立的数据孤岛?
第二,如何把这些孤岛连接起来形成知识网络?
第三,在知识网络之上,如何进一步形成能够生产、流通、使用和反馈的数据生态。
先讲困境,我们这里讲的数据孤岛不只是指数据存放在不同的服务器里面,而是更深层次的割裂。不同数据难以对齐、AI-Ready不足、缺少统一标准、缺少真正的流通机制,最终无法有效汇聚、关联或复用。
我们把它概括为模态孤岛、标签孤岛、标准孤岛、流通孤岛。
第一,模态孤岛。理论数据大而不真,覆盖空间广,但缺少真正实验校验;实验数据真而不够,可信度高,但成本高、规模有限;文献数据散而不联,大量知识沉淀在论文中,却高度非结构化。因此,真正的问题是理论、实验、文献之间无法形成相互校准、相互补充的体系。
第二,标签孤岛。我们拥有庞大的分子和材料的结构空间,但真正对应的功能和性能数据极其稀疏。一个结构往往只有少数的性质标签,难以支撑多任务训练,同时已有数据还存在明显的幸存者偏差,大量失败实验、负结果和工况信息没有被记录,因此距离真正全面的AI-Ready科学数据还有很大的差距。
第三,标准孤岛。不同实验室、不同装置、不同数据库之间,数据格式、元数据或接口都不统一,形成大量数据“方言”,很多PB级的装置数据虽然已经产生,却依然沉睡在硬盘里。数据能存,但机器难以批量理解、比较、复现,规模再大也难以直接应用于科学智能。
第四,流通孤岛。现在科研数据普遍面临三个问题,不愿共享、不敢共享、不易共享。不愿共享,是因为数据往往被认为是课题组的核心资产,而现有评价体系对数据贡献的激励不足;不敢共享,是因为涉及知识产权、安全或科研伦理;不易共享,是由于缺乏标准化、可互操作的数据基础设施。最终形成一种非常矛盾的状况:数据很有价值,却流动不起来。
从数据孤岛走向知识网络
如何破局?我们的核心思路是构建知识网络,把散落的数据逐级提纯,最底层的是谱学、结构、性质、文献、装置等原始数据,再经过清洗、标准化和结构化,形成机器可读的信息,进一步把实体和关系组织成知识图谱,最后由大模型等科学智能系统基于知识网络开展预测、推理和发现。
要完成这一任务,可以分四步走:
第一步,让科学数据在产生之初就完整、规范、可信。源头数据的质量决定了整个知识网络的上限,我们的解决方案是打造具有科研思维的全流程机器化学家,让机器同时具备能读、会算、勤做的能力,把计算预测和真实实验反馈结合起来,自动生成适用于智能训练的多模态、可追溯的数据。目前机器在数据产生的精度和速度两个维度上都已超越了人工实验。
我们将复杂的实验室操作拆解为标准化基元指令集,通过统一的标准指令集、通信协议和实验室规范,打通多个厂家、多个数据接口的设备,搭建全流程工艺智能管控系统,满足数据可发现、可访问、可互操作、可复用的原则。目前我们实验室已经积累了近200台智能工作站,覆盖固体进样、磁力搅拌、滴液制样、光谱表征、质谱分析、催化测试等全流程环节。
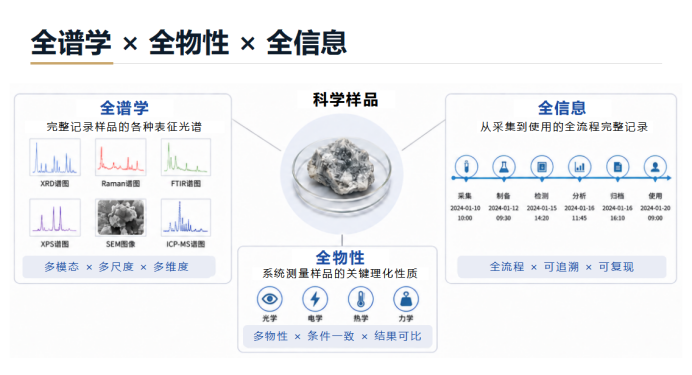
在这套系统基础上,提出了全谱学、全物性、全信息。全谱学是针对同一个科学样品,尽可能完整地记录多模态、多尺度、多维度的表征光谱;全物性是在一致性条件下系统测量关键理化性质,使结果可比;全信息是记录从采集、制备、检测、分析到归档、使用的全过程。我们希望未来一个科学样品对应的不再是零星的数据,而是一套完整的数字档案。
第二步,让数据之间形成真正有科学含义的连接。传统数据库回答的是“有什么”,科学研究更关心“为什么有关、这种关系是否可靠、下一步做什么”。因此我们要从孤立的数据对象走向知识网络,把结构、性质、反应、文献、实验条件或证据来源连接起来,并进一步连接到计算和实验任务中去。
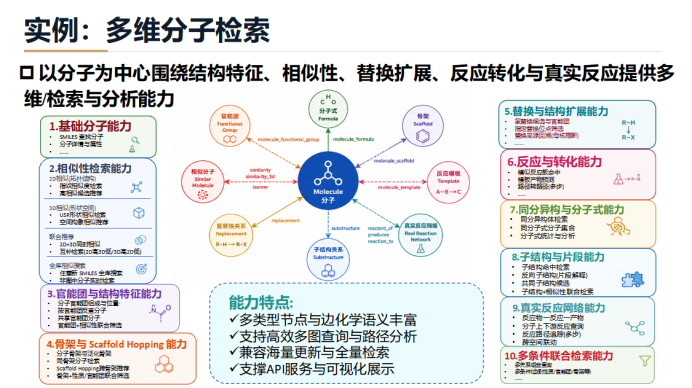
以分子检索为例,传统的检索往往只要梳理一个SMILES文件,再找相似结构。现在形成知识网络以后,我们就可以同时从二维拓扑、三维构象、官能团、骨架、子结构、结构替换、真实反应和反应路径等多个维度联合检索,这样数据库就不再只是用来查数据,而是开始具备结构扩展、路径分析、候选推荐等能力。
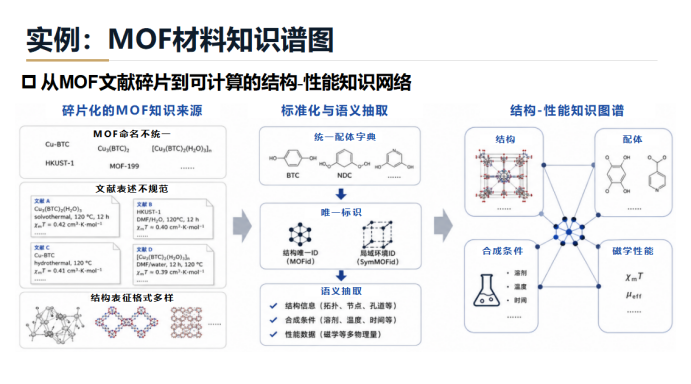
再比如MOF材料,过去相关的知识散落在大量文献中,同一配体可能有不同的名称,合成条件表达也不系统统一,结构表征格式也不同。现在,我们可以通过统一配体字典,建立唯一标识和语义抽取,我们可以把结构、配体、合成条件和性能连接起来,形成可计算的“结构—性能”知识网络,把文献碎片转化为机器可以推理的知识。
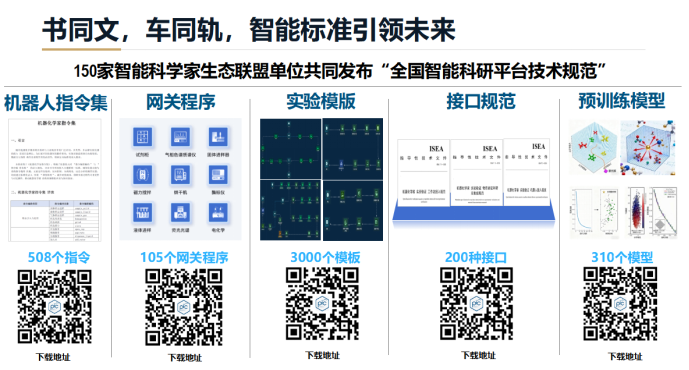
第三步,让数据和知识真正流动起来。数据要流动,生态是关键,数据产生者、治理者、组织者、使用者和生态保障者,需要各司其职,并在任务、标准、数据和反馈之间形成持续循环,只有这样数据生态才能真正地运转起来。中国有句古话“书同文,车同轨”,标准是数据流动的基础,我们联合150家智能科学家生态联盟单位,共同发布了“全国智能科研平台技术规范”,涵盖508种机器人指令,105个网关程序,3000多个实验模板,200多种接口规范和310个预训练模型,并全部开放下载,为科研平台互联互通提供统一的普通话。流动还要解决安全和隐私问题,很多科学数据由于知识产权和商业价值不能直接共享,针对这样的问题我们采取了联邦学习,也就是数据不动,模型动,数据保留在各课题组本地,让模型参数在不同节点之间流动,从而既保护了数据又实现了多方协同学习。
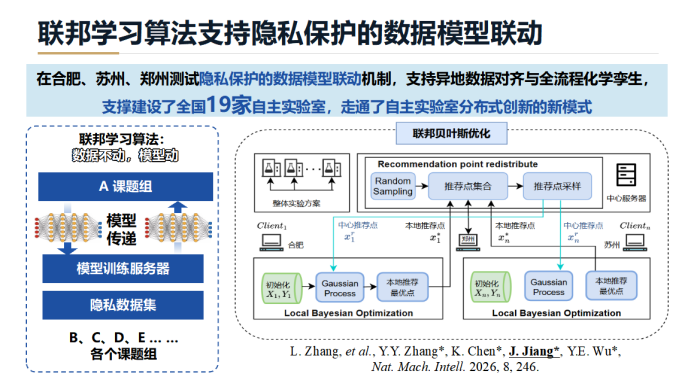
基于这些标准和联邦学习机制,我们已经实现19个分布式智能创新设施的数据汇聚,包含厦门大学、浙江大学、国科大等高校院所科研平台,还包括中国华能、中国石化、中国五矿等产业平台,形成任务下发、数据回传、产业反哺、模型迭代的化学孪生创新网络。
第四步,让数据真正催生科学智能,最终反过来赋能科研与产业。前面讲到的数据汇交、治理、流通和使用不能彼此割裂,而要形成闭环。数据产生模型和科研结果,模型提出新的实验任务,实验再生成新的高质量数据,系统才能持续地进化。目前我们已经启动了数据、模型、实验科研飞轮,一方面用海量数据支撑大模型大胆假设,从巨大的科学空间中提出科学问题,另一方面用科研机器人和智能工作站产生精准小数据,支撑专业小模型小心求证,优选方案后再用机器人开展实验验证,并反馈到模型和数据系统中,最终形成自主创制新物质、发现新知识的能力。
科研与产业应用
为大家分享三个落地的案例:
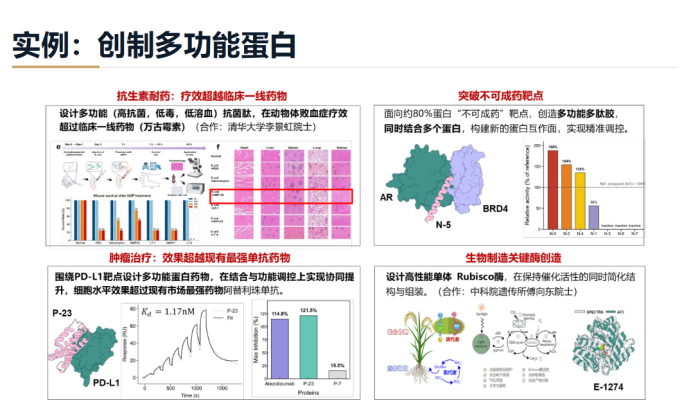
第一,创制多功能蛋白。我们利用32万条数据训练了一个拥有12亿参数的蛋白质谱学大模型,实现将蛋白质设计从单功能突破推进到多功能具身智能工程化阶段,并在生命科学、合成生物和农药领域实现应用,研发效率提升超百倍。例如我们设计的多功能抗菌肽,在动物败血症模型中治疗效果超越临床一线药物万古霉素;同时面向大量不可成药的靶点,设计出多功能多肽胶,可以结合多个蛋白实现更精准的控制。
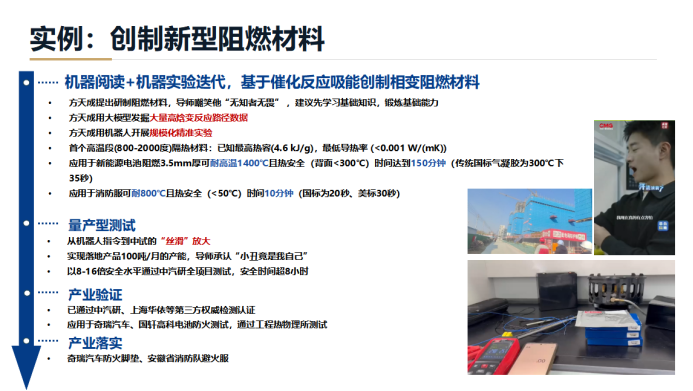
第二,创制新型阻燃材料。这个工作从大模型挖掘高焓变反应路径数据开始,再通过机器人开展规模化精准实验,最后形成面向实际工程需要的相变阻燃材料,在1400摄氏度下能保证150分钟的热安全,而传统国标气凝胶在300摄氏度下只能坚持35秒。这种材料不仅完成了实验室的验证,还进入了中试第三方检测和产业应用。从机器人指令到规模化生产,可以较为顺利地实现放大,说明数据和智能化系统最终必须走向真正的产业场景,而不是只停留在模型指标上。
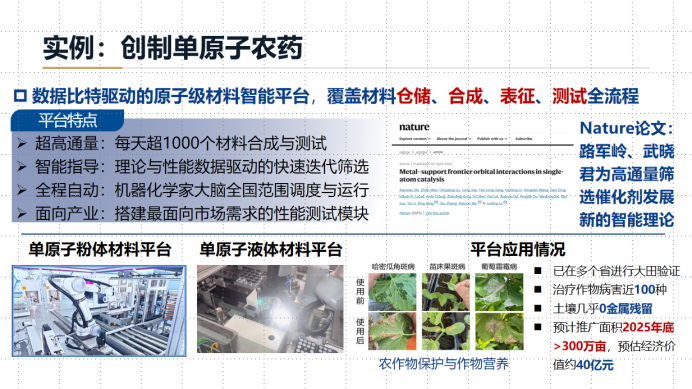
第三,创制单原子农药。通过原子级材料智能平台,我们每天能够完成超过1000个材料合成与测试。持续驱动快速筛选,创制单原子农药,已经在云南等多个省完成了大田验证,能够防治近百种作物病害,土壤中几乎没有重金属残留。截至2025年底,推广面积已经超过300万亩,经济价值约40亿元。
基于前面的实践,我想提几点建议:
第一,建设面向科学智能的国家科学数据采集系统。从源头统一规划数据采集、标注和汇交,覆盖理论、实验、文献和大科学装置等不同模态。
第二,尽快完善国家科学数据标准体系,统一数据格式、元数据和语义口径。因为没有标准化的海量真实数据,是不可能有真正意义上的科学智能。
第三,推动大科学装置数据从沉睡走向联网,建立跨装置的数据共享和联合分析机制,使这样的昂贵科学设施产生的数据,真正变成可持续增值的国家知识资产。
第四,要建立数据不动、模型动的开放共享机制。利用联邦学习等隐私计算,让数据在安全边界内发挥价值。我们需要改变一个观念,共享并不等于把数据全部交出来,未来完全可以实现安全可控的数据价值的流动。
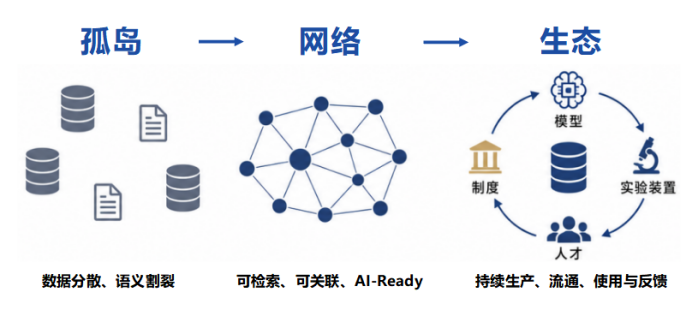
最后,科学数据能力的建设可以看成三个阶段:
一是打破孤岛,解决数据分散、语义割裂问题。
二是构建网络,数据开始可检索、可关联、AI-Ready。
三是形成生态,数据能够持续生产、流通、使用与反馈。最终,我们希望形成这样的一条路径:以数据为基、以知识为网、以生态赋能科学智能。
科学智能时代的大门已经开启,数据是这个时代最基础的战略资源,是我们这代科学工作者必须夯实的底座,我愿与在座各位深入合作,共同把科学数据这篇大文章做好,让数据真正成为中国科学智能的底气,让中国丰富的科学数据真正转化为可持续产生新知识、新材料和新技术的创新能力,谢谢大家!
链接:https://mp.weixin.qq.com/s/G3sj1KymzGMqNMTASBHQ_g


